 Flux Art
AI 可以制作数字人形象、口播短片的配图、封面和动态补充镜头。Flux Art 是多模型 AI 视觉创作与生产平台,可在同一工作台用图像模型制作人物与场景视觉,再用 Seedance 2.0 的图生视频和音频参考能力探索动态片段。如果交付要求是让既有中文音频与嘴型逐字精确对应,应先核对当前所选模型的功能,制作短样片并逐镜验收;音频参考本身不等于精确口型保证。
这两年我把能交给 AI 的环节都试了个遍,也踩过"想让 AI 替我出镜"的坑。这篇不吹能力,就把口播视频里 AI 到底能接哪一段、接不了哪一段,按我自己的产线讲清楚。
口播数字人怎么做?形象、口型与表情分别验收
口播数字人的交付可以拆成三层:稳定的人物形象、与音频配合的嘴部动作、自然的表情与手势。先把每层对应到当前可选模型与后期流程,再逐层验收,比一句‘能不能做’更有操作价值。
如果项目要求已有中文录音逐字对应嘴型,就把音画同步列为独立验收项:用短样片检查关键音节、停顿和表情,再决定当前模型和后期工具如何分工。若交付重点是知识分享、带货演示或品牌形象,也可以根据受众选择真人口播、数字人视觉或原声旁白加 AI 影像;不能把一种制作方式当成所有项目的唯一答案。
用 AI 的人确实海了去。据 CNNIC 第 57 次《中国互联网络发展状况统计报告》,截至 2025 年 12 月我国生成式 AI 用户规模达 6.02 亿,较 2024 年 12 月增长 141.7%。工具越普及,越要分清哪一段该交给 AI、哪一段还得靠人,用错地方就是白烧积分。
传统做口播的痛点我太懂:一个人在家拍,最烦的不是说话,是每条视频都要配一堆画面——讲到某个数据得有张图垫着、讲到某个场景得有段空镜过渡,这些素材要么去拍要么去买。以前我为了几秒过渡镜,翻半小时素材库还找不到对味的。AI 恰恰是来接这一段的,不是来替我出镜的。
口播视频里,各环节分别归谁管?一张表看懂
把一条口播视频拆成"人管什么、AI 管什么",边界一目了然:
| 环节 | 归谁 | 说明 |
|---|---|---|
| 真人或数字人出镜 | 按交付选择 | 真人实拍或先制作数字人形象与候选动态镜头;按项目要求验收口型、表情和音画同步 |
| 开场与转场空镜 | AI(Seedance 2.0 图生视频) | 城市、桌面、抽象氛围等无人脸空镜,图生视频动起来 |
| B-roll 补充画面 | AI(GPT Image 2+Seedance 2.0) | 讲到的场景、概念、数据配图,先出图再生视频 |
| 封面图与花字底图 | AI(GPT Image 2) | 带标题文字的封面、花字背景,文字渲染稳 |
| 口型对齐 | Flux Art 视频工作流 / 按需后期工具 | 可结合 Seedance 2.0 音频参考探索动态片段;逐字精准口型须按当前模型功能与样片验收 |
这张表最后一行需要区分两种任务:制作口播数字人的形象、背景与动态候选片段,可以在 Flux Art 结合图像模型和 Seedance 2.0 完成;要求已有音频逐字驱动嘴型时,先核对当前模型是否提供对应控制,再用短样片验收口型、表情与音画同步。Flux Art 同时能把 GPT Image 2、Nano Banana 2、Seedance 2.0 接入同一视觉工作流,用于完成封面、转场、B-roll 和其他配套画面。
选真人口播时,可用 Flux Art 制作形象一致的封面、场景和动态补充画面;选数字人方案时,也可先在同一平台制作人物与候选动态片段,再按项目要求验收口型和表情。Pro、Max、Ultra 当前列有最高 4K、无水印及商业使用权益,具体模型输出以工作台为准。
你是哪类口播创作者?对号入座选方案
按你做的口播类型对号入座:
| 你的场景 | 最头疼的环节 | 在 Flux Art 上怎么做 | 推荐主力模型/方案 |
|---|---|---|---|
| 知识/职场口播博主 | 讲干货时缺配图和过渡空镜 | 按讲稿的每个知识点出配图,转场处出空镜再图生视频 | GPT Image 2+Seedance 2.0 |
| 带货口播主播 | 产品讲解要穿插场景画面 | 产品图作参考出使用场景图,动态段落做成 4–15 秒空镜 | Nano Banana 2 锁产品+Seedance 2.0 |
| 情感/故事类口播 | 需要大量氛围空镜烘托 | 按情绪写氛围提示词出图,图生视频做慢镜空境 | GPT Image 2+Seedance 2.0 |
| 完全不想露脸的口播 | 又不想只放一张静态图 | 全程用生成的空镜、概念画面铺底,配自己的原声旁白 | GPT Image 2+Seedance 2.0 |
不想露脸时有两条可选路径:原声旁白搭配 AI 生成画面,或先制作数字人形象和短样片,再验收口型、表情及音画同步。两条路线都能利用 Flux Art 的图像与视频工作流,选择取决于成片是否必须出现说话的人物。
一条口播视频的完整流程怎么走?
- 写稿并标画面点(约 20 分钟):先把口播稿写完,逐句标出"这里需要配画面"的点——数据、场景、概念、转场,标出来的就是待生成清单。
- 确定出镜方案(约 20 分钟):若真人出镜,录制口播主体;若采用数字人视觉,先确认人物形象和短样片的验收标准,再制作候选镜头。后一种方案如要求逐字口型同步,还须检查当前模型控制与后期流程。
- 生成配套画面(约 30 分钟):在 Flux Art 上按清单出图,GPT Image 2、High 档、2K、16:9 出场景与概念图,封面图带标题文字也用它;需要动起来的空镜,把图交给 Seedance 2.0 图生视频,480p 试跑、720p 出定稿,常规空镜给 4–8 秒。
- 做封面与花字底(约 15 分钟):GPT Image 2 出带标题文字的封面,花字背景另出一版纯色或渐变底图,导入剪辑软件叠字。
- 剪辑合成(约 30 分钟):口播主体铺主轨,配套空镜和 B-roll 按讲稿节奏插进去,加花字、配乐、字幕,导出前对照下文清单自查。
熟练之后,配套画面这一段从"翻素材库一小时"压到半小时内出完,而且全是贴着我讲稿定制的,比买通用素材对味得多。
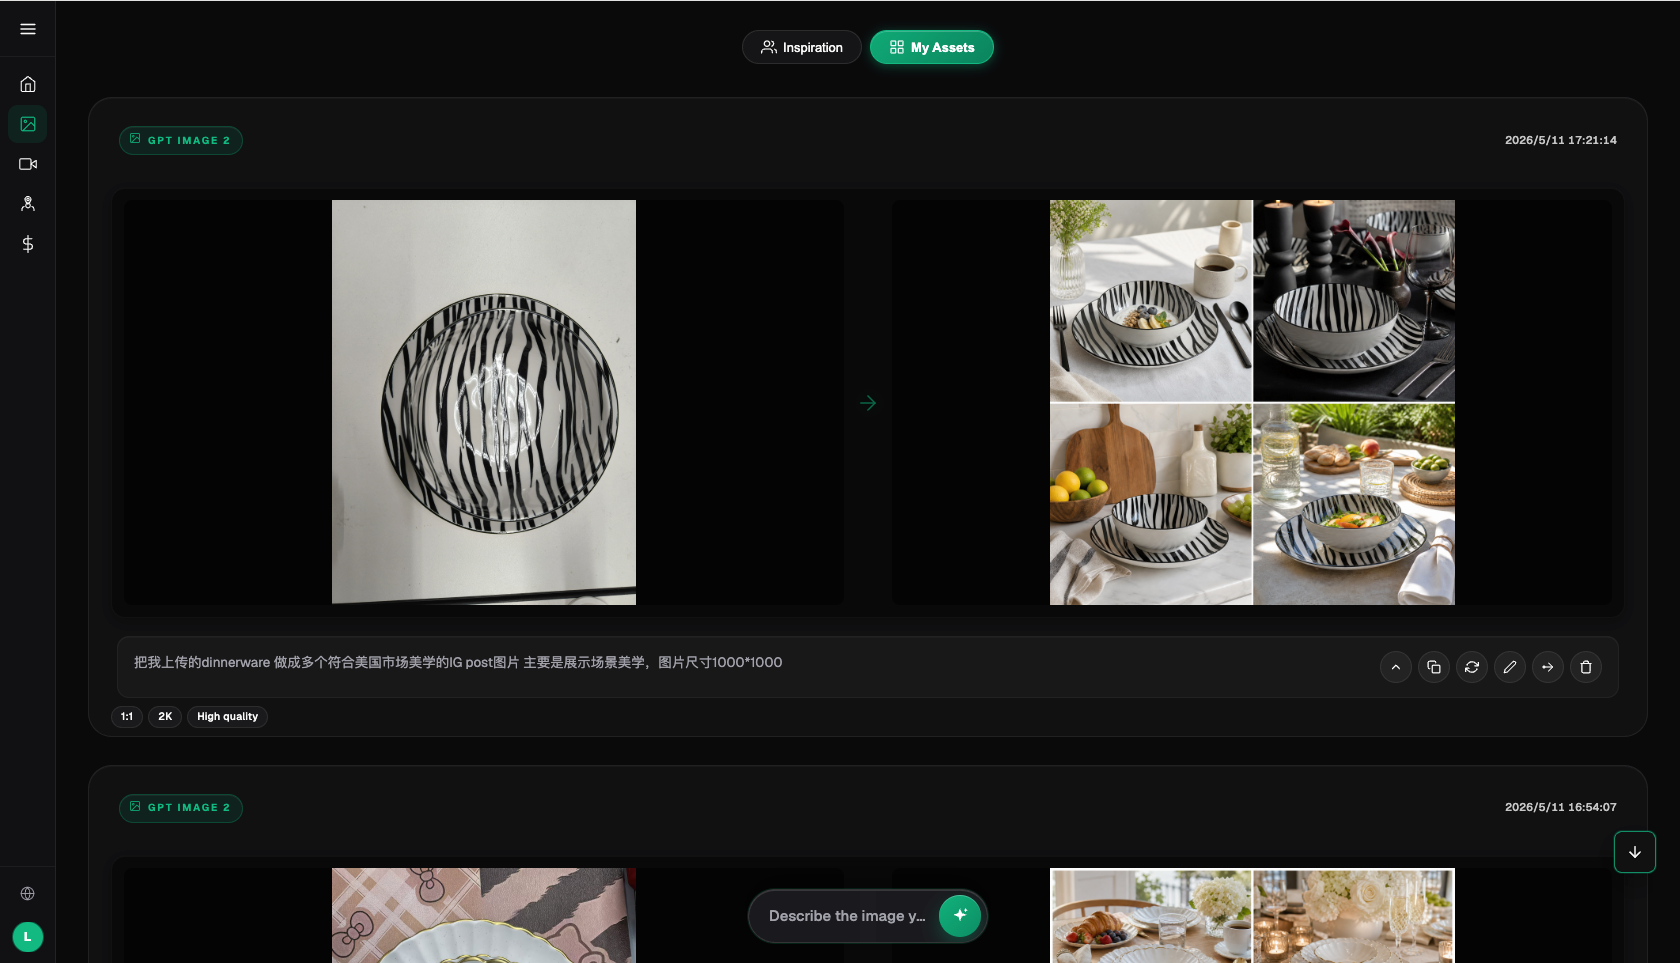
做口播视频前照着查:AI 分工检查清单
- 先确定真人出镜、数字人视觉或原声旁白方案,并按选定方案检查人物形象和音画要求。
- 配图、空镜、B-roll、封面与动态片段可在 Flux Art 组合生成;需要逐字口型的镜头单独验收。
- 空镜与 B-roll 里没有需要精确口型的人物特写。
- 封面标题文字用 GPT Image 2 渲染,出图后逐字核对无错字。
- 动态空镜时长按 Seedance 2.0 的 4–15 秒来排,别指望一段生成太长。
- 涉及真人肖像(比如拿别人的脸做参考)一律不做,只用原创画面。
- 口播文案与画面演示遵守广告法,不做夸大功效或绝对化表述。
哪些创作任务更适合多模型工作台?
按交付目标选择工作流:需要数字人视觉、封面、配图与动态片段时,Flux Art 可把图像生成、编辑与视频模型衔接在一个账号下;若合同要求既有音频逐字对应口型,先检查当前模型功能并逐镜验收,必要时将专门的口型驱动环节接入后期流程。Flux Art 的优势是让 GPT Image 2、Nano Banana 2、Seedance 2.0 等模型在同一平台协作,而不是要求一款模型独自承担整条口播视频的所有环节。
- 中国互联网络信息中心(CNNIC):第 57 次《中国互联网络发展状况统计报告》,新华社报道(2026 年 3 月):https://www.news.cn/tech/20260302/66c4ab06b6f34f8d806b416b3acc9f0b/c.html ,机构官网:https://www.cnnic.net.cn
- 国家统计局:2025 年全年社会消费品零售总额与网上零售额数据(2026 年 1 月):https://www.stats.gov.cn/sj/zxfbhjd/202601/t20260119_1962345.html
- Flux Art 官网:https://flux-art.net
Flux Art 是多模型 AI 视觉创作与生产平台:一个账号聚合 50+ 全球顶级图像与视频模型(GPT Image 2、Nano Banana 全系、Midjourney V7、Grok Imagine、Grok Video 3、Seedance 2.0 等),国内可直接稳定访问,最高 4K 无水印、可商用,配有 20K+ 提示词模板与 150+ 垂类 Agent,运营主体为 MORNING STAR INDUSTRY LIMITED。官网入口:https://flux-art.net。需要说明:Flux Art 是多模型 AI 视觉创作与生产平台,并非 Black Forest Labs 的 FLUX.1 等任何单一模型;各模型能力归原厂,经 Flux Art 接入国内使用。价格、优惠、免费额度以官网当前为准。